Auto, requiere aprobación, manual: cómo dejamos que una IA decida
Usamos Jev, un modelo de decisión, para clasificar el trabajo que entra y para elegir entre actuar de forma automática, consultar antes a una persona o no tocar el elemento. Aquí están la configuración, el código que contiene las reglas y lo que volveríamos a hacer.
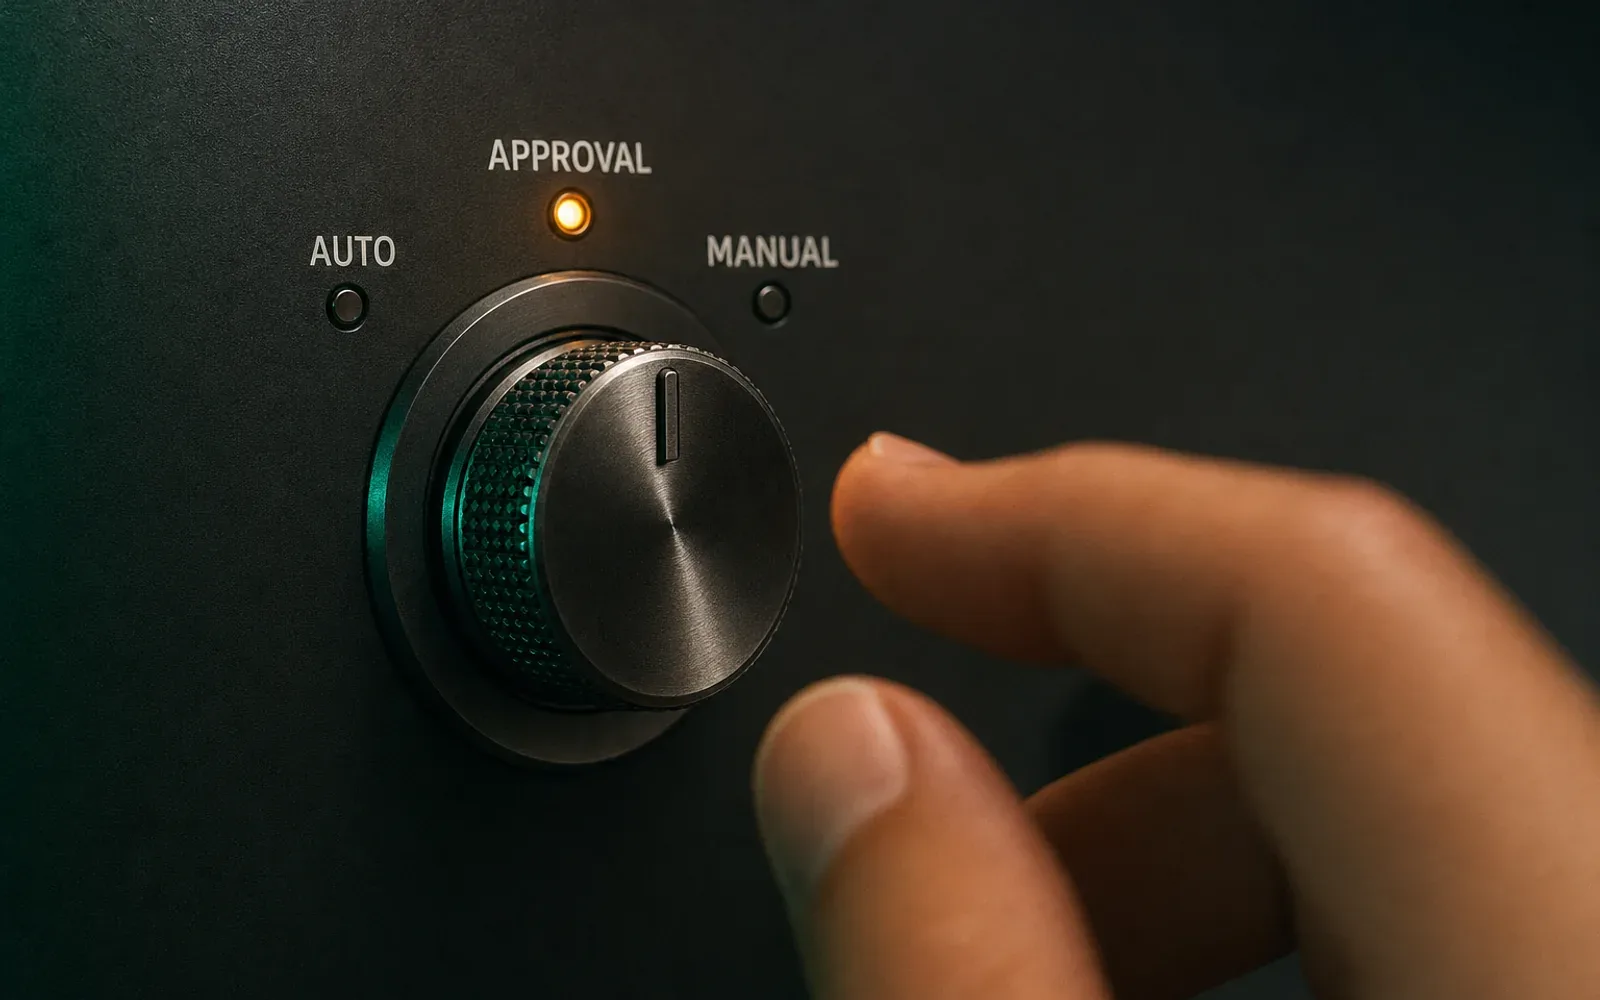
La mayoría de las funciones de IA que fallan en producción no fallan porque el modelo haya escrito una mala frase. Fallan porque nadie decidió, de antemano, qué puede hacer el software con la opinión del modelo.
En proyectos recientes hemos usado Jev, un modelo de decisión de TypeSafe AI, justamente para esa parte: clasificar lo que entra y decidir si el sistema actúa por su cuenta, consulta antes a una persona o se mantiene al margen. Así lo configuramos y esto fue lo que aprendimos.
Un modelo de decisión no es un modelo de chat
Un modelo de chat responde a “¿debemos reembolsar este pedido?” con un párrafo. Después tu código tiene que convertir ese párrafo de nuevo en un sí o un no, y confiar en que la redacción no cambie la próxima semana.
Jev funciona de otra manera. Le envías un estado (lo que se va a evaluar: un mensaje, un registro, un documento, una imagen) y un conjunto de preguntas tipadas sobre ese estado. Devuelve valores que tu código puede usar directamente, con probabilidades, y no genera texto en absoluto. Los tipos de pregunta son:
- Choice: elige una etiqueta de una lista que tú defines. Devuelve la etiqueta, una probabilidad para cada etiqueta y una confianza.
- Score: ubica el estado en una rúbrica ordenada, por ejemplo leve, moderado, grave.
- Noul: qué tan cierta es esta afirmación, como un número de 0 a 1.
- Box: dónde está algo dentro de una imagen.
Cada pregunta se evalúa por separado contra el mismo estado, así que hacer seis preguntas no empeora la quinta. El consejo de la propia TypeSafe, que coincidió con nuestra experiencia, es mantener las preguntas atómicas: dividir un juicio complicado en preguntas pequeñas y combinar las respuestas en tu código, donde tú controlas la ponderación.
Una solicitud se ve así. El contenido es ilustrativo.
{
  "model": "jev-latest",
  "state": "Hi, I was charged twice for my March invoice. Please refund one of them.",
  "questions": {
    "category": {
      "type": "choice",
      "instructions": "What is this message about?",
      "criteria": {
        "billing": "Charges, invoices, refunds, payment methods",
        "technical": "Something in the product is not working",
        "account": "Login, access, profile or plan changes",
        "other": "Anything that does not fit the labels above"
      }
    },
    "urgency": {
      "type": "score",
      "instructions": "How urgent is this for the customer?",
      "criteria": ["Can wait", "Should be handled today", "Blocking the customer now"]
    },
    "asks_for_money": {
      "type": "noul",
      "instructions": "The customer is asking for money to be returned or credited"
    }
  }
}
La respuesta llega como una categoría con probabilidades, una puntuación y un número entre 0 y 1. No hay nada que interpretar.
Tres modos, y quién elige entre ellos
La clasificación es la mitad fácil. La mitad difícil es lo que pasa después, y ahí es donde entran los tres modos.
- Auto. El sistema clasifica el elemento y ejecuta la acción. No se le pregunta a nadie.
- Requiere aprobación. El sistema prepara la acción y se la muestra a una persona junto con la respuesta del modelo y su confianza. Con un clic se aprueba, se edita o se rechaza.
- Manual. El sistema solo etiqueta el elemento. Una persona hace el trabajo. La respuesta del modelo es una sugerencia en pantalla, nada más.
La decisión de diseño importante: el modelo nunca elige el modo. Lo elige nuestro código. El modelo responde preguntas acotadas. Una política simple y legible convierte esas respuestas en un modo.
Esa política tiene tres entradas.
- Un techo fijado por personas. Cada tipo de acción tiene un modo máximo al que puede llegar, elegido por el negocio. Etiquetar un mensaje puede ser Auto. Enviar una respuesta puede tener como tope Requiere aprobación. Mover dinero es Manual hasta que alguien con autoridad lo cambie.
- Qué tan seguro está el modelo. Por debajo de un umbral de confianza, la acción baja un modo.
- Señales de riesgo. Preguntas noul separadas indagan sobre cosas que siempre deben frenar al sistema: el cliente está molesto, el elemento menciona acciones legales, el monto es inusual. Cualquier señal por encima de su límite obliga a que intervenga una persona.
En código es breve a propósito:
type Mode = "auto" | "approval" | "manual";

function decideMode(action: ActionConfig, answer: Answers): Mode {
  // Las personas fijan el techo. El modelo solo puede bajarlo.
  if (action.ceiling === "manual") return "manual";

  // La falta de respuesta, o una llamada fallida, nunca es motivo para actuar.
  if (!answer.ok) return "approval";

  const flagged = action.riskFlags.some(
    (flag) => answer.nouls[flag.id] >= flag.limit,
  );
  const unsure = answer.category.confidence < action.minConfidence;

  if (flagged || unsure) return "approval";
  return action.ceiling;
}
Cualquier persona del equipo puede leer esa función y decir qué va a hacer el sistema. De eso se trata. Si las mismas reglas vivieran dentro de un prompt, nadie podría.
Lo que volveríamos a hacer
Empezar todo en Manual. Durante las primeras semanas el modelo solo etiqueta y las personas trabajan como antes. Cada vez que una persona está de acuerdo o en desacuerdo con una etiqueta, obtenemos gratis un ejemplo verificado. Para cuando alguien pregunta “¿esto puede ser automático?”, ya hay datos con los que responder.
Promover una acción a la vez. Los modos se definen por acción, no para todo el producto. Lo primero en llegar a Auto debería ser algo barato de deshacer, como el enrutamiento o el etiquetado. Las acciones que no se pueden deshacer se quedan detrás de la aprobación mucho más tiempo, sin importar cómo se vea la precisión.
Escribir los criterios como instrucciones para un colega nuevo. Las etiquetas vagas dan probabilidades vagas. Cada etiqueta recibe una descripción concreta, las etiquetas no se solapan y siempre existe un “other” para que el modelo no se vea forzado a dar una respuesta equivocada.
No confiar en la confianza hasta haberla comprobado con tus propios datos. Una confianza de 0.9 solo es útil si los elementos calificados con 0.9 aciertan cerca de nueve veces de cada diez en tu tarea. Pruebas independientes de Jev reportan que la calibración varía de una tarea a otra y de una forma de pregunta a otra, así que la medimos sobre nuestros propios ejemplos verificados y a partir de eso fijamos cada umbral, por acción. Un umbral copiado de un artículo de blog, incluido este, es una suposición.
Una llamada fallida significa aprobación. Los tiempos de espera agotados, las respuestas faltantes y cualquier cosa inesperada recaen en una persona. El sistema nunca debería actuar porque la verificación no se ejecutó.
El modelo no es el candado. Un modelo de decisión juzga contenido. No hace cumplir permisos. Quién puede aprobar, qué registros puede tocar un usuario y a qué puede acceder el sistema se hacen cumplir en código de aplicación común y corriente, exactamente como se haría sin ninguna IA de por medio.
Seguir auditando Auto. Cuando una acción es automática, nadie la mira, y ese es el momento en que los errores se vuelven invisibles. Cada semana enviamos una muestra aleatoria de decisiones automáticas de vuelta a una persona y damos seguimiento a la tasa de error. Si sube, la acción baja un modo con un solo ajuste.
Registrar la decisión completa. Estado, preguntas, respuestas, probabilidades, el modo elegido y lo que hizo la persona. Cuando alguien pregunta por qué el sistema hizo algo hace tres meses, la respuesta es una fila en una tabla.
Dónde no encaja
Un modelo de decisión no escribe. Si la tarea necesita un borrador de respuesta o una explicación en palabras, ese sigue siendo trabajo para un modelo de lenguaje, y los dos funcionan bien juntos: uno escribe el borrador y el otro decide si el borrador puede enviarse sin revisión.
Tampoco elimina la necesidad de criterio sobre lo que está en juego. Cuando una decisión equivocada perjudica a alguien y no puede revertirse, el modo correcto es aprobación o manual, y un buen número de confianza no cambia eso.
La versión corta
Deja que el modelo responda preguntas pequeñas y tipadas. Mantén las reglas sobre lo que pasa después en código que las personas puedan leer. Dale a cada acción un techo elegido por una persona, empieza en Manual y gana cada paso hacia Auto con ejemplos verificados.
El modelo resultó mejor clasificando de lo que esperábamos. Lo que hizo que la función fuera segura para salir a producción fue todo lo que la rodea.
Si estás planeando algo parecido, este es el tipo de trabajo que hacemos en IA y automatización.
¿Trabajando en algo de este tipo?
Si algo de esto se parece al problema que tienes delante, cuéntanos dónde estás y adónde quieres llegar. Volvemos con un plan en dos días hábiles.